Стартап TypeSafe AI выпустил Jev, первую публичную модель нового класса System One Models для автоматизации внутри программного обеспечения. Вместо текстовых ответов она должна выдавать типизированные решения с вероятностями и оценкой уверенности. Это позволяет коду самому выбирать действие или отправлять задачу на проверку человеку. Компания противопоставляет этот подход чат-моделям, оптимизированным для общения с людьми.
В TypeSafe AI считают, что обучение языковых моделей с подкреплением на основе человеческой обратной связи, или RLHF, сделало их особенно хорошими в следовании инструкциям и диалоге. Но для автоматизации, по версии разработчиков, такой подход создаёт проблемы: модели могут терять режимы работы, отвечать с чрезмерной уверенностью и работать недостаточно надёжно. Поэтому им требуется контроль человека.
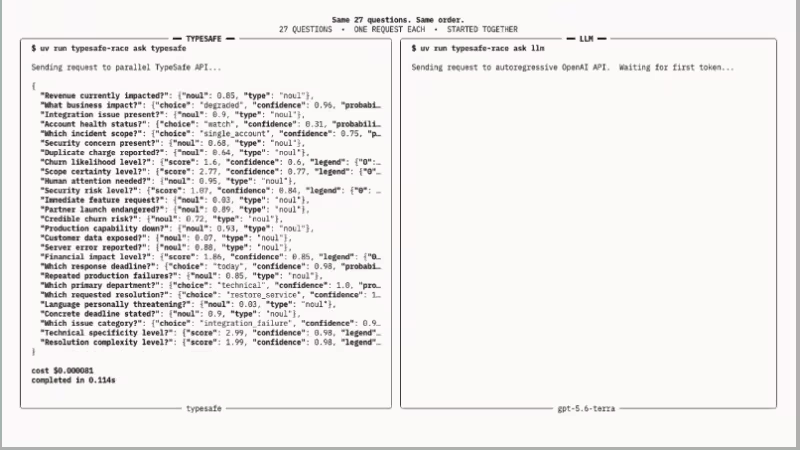
Jev предназначен для другой схемы работы. Разработчик отправляет модели структурированный вопрос, а в ответ получает решение определённого типа, вероятность и показатель уверенности. В коде можно задать пороги: при высоком уровне уверенности система действует самостоятельно, при низком передаёт запрос на проверку. Несколько таких решений можно объединять в более крупные рабочие процессы.
TypeSafe AI называет Jev моделью, ориентированной на решения, а не на строки текста. Компания утверждает, что благодаря этому она работает быстро, согласованно и подходит для применения в коде. В описании сервиса также заявлено об отсутствии галлюцинаций: каждое решение сопровождается оценкой уверенности, которую программа использует при дальнейшей обработке.
По расчётам TypeSafe AI для задач класса System One Jev в 193,6 раза быстрее и в 444,6 раза дешевле обычных LLM. В приведённом сравнении выполнение задачи с моделью заняло 0,114 секунды и обошлось в $0,000081, тогда как у LLM те же показатели составили 8,566 секунды и $0,013880. Входные токены Jev стоят $42 за миллиард, что компания оценивает как цену в 238 раз ниже, чем у Claude Fable 5.1.
В основе System One Models лежат новая архитектура, новый сэмплер и метод обучения Reinforcement Learning for Calibrated Decisions, или RLCD. TypeSafe AI описывает эту технику как обучение с подкреплением для калиброванных решений. Модель стала первым публичным представителем этого класса и оптимизирована для автоматизации.